Publicar una página no significa que vaya a aparecer automáticamente en Google. Antes de que una URL pueda mostrarse en los resultados, el buscador necesita descubrirla, acceder a ella, procesar su contenido y determinar si debe incorporarla a su índice. Comprender la diferencia entre indexación vs rastreo en Google resulta fundamental para diagnosticar correctamente los problemas de visibilidad de cualquier web. Una página puede ser conocida por Google y no haber sido rastreada todavía, puede haber sido rastreada pero no indexada o puede estar indexada sin conseguir posiciones relevantes.
En nuestra empresa diferenciamos claramente estos procesos cuando realizamos una auditoría SEO técnica. No tiene sentido intentar solucionar un problema de indexación modificando elementos que únicamente afectan al descubrimiento de URLs, del mismo modo que aumentar los enlaces internos no resolverá necesariamente una exclusión provocada por canonicalización o contenido duplicado. Google confirma que no todas las páginas rastreadas terminan necesariamente indexándose: después del rastreo, sus sistemas evalúan y procesan cada página para determinar si es adecuada para el índice.
Qué significa rastreo en Google
El rastreo es el proceso mediante el cual Google accede a las URLs para descubrir su contenido y detectar enlaces que puedan conducir hacia otras páginas. Googlebot es uno de los rastreadores utilizados para realizar esta tarea.
Dentro de la comparación indexación vs rastreo en Google, podemos considerar el rastreo como la fase de exploración. El buscador necesita conocer una URL y poder acceder a ella antes de procesar correctamente la información que contiene.
Google dispone de recursos limitados y no puede explorar continuamente todas las URLs públicas existentes en internet. Por este motivo, sus sistemas determinan cuánto tiempo y recursos destinan a rastrear cada sitio, concepto habitualmente denominado presupuesto de rastreo.
Cómo descubre Google una URL
Google puede encontrar páginas siguiendo enlaces desde otras URLs que ya conoce. Esta es una de las razones por las que una arquitectura web clara y un buen enlazado interno son importantes para el SEO técnico.
Los sitemaps XML constituyen otra vía para comunicar qué URLs queremos que los motores de búsqueda conozcan. Google recomienda utilizarlos para informar sobre páginas nuevas o cambios, aunque incluir una URL en un sitemap no equivale a garantizar su indexación.
Los enlaces externos también pueden permitir el descubrimiento de una página. Si otra web enlaza un contenido nuestro, los rastreadores pueden llegar hasta él siguiendo esa referencia.
Qué significa indexación en Google
La indexación ocurre cuando Google procesa una página y puede incorporarla a su índice para utilizarla potencialmente en los resultados de búsqueda.
Esta diferencia es esencial para comprender indexación vs rastreo en Google: rastrear significa acceder y analizar una URL, mientras que indexarla implica procesarla dentro de los sistemas de búsqueda y considerarla candidata para aparecer en resultados.
Que Google haya visitado una página no garantiza que vaya a indexarla. Su propia documentación señala expresamente que no todas las páginas rastreadas terminan incluyéndose en el índice.
Qué analiza Google durante la indexación
Durante el procesamiento, Google intenta comprender el contenido principal y también puede identificar páginas duplicadas o muy similares. Cuando encuentra varias versiones equivalentes, puede agruparlas y seleccionar una URL representativa o canónica.
Esto explica por qué algunas URLs pueden haber sido rastreadas correctamente y, sin embargo, no aparecer individualmente en los resultados. El problema no siempre está relacionado con la capacidad de Googlebot para acceder a ellas.
Indexación vs rastreo en Google: cuál es la diferencia principal
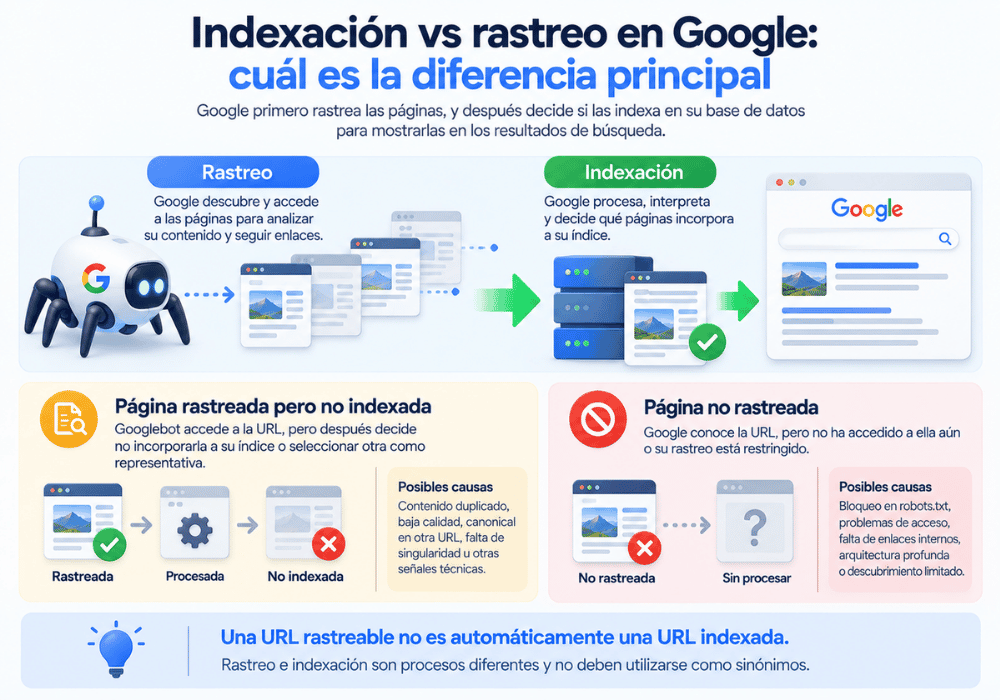
La diferencia puede resumirse mediante una relación sencilla: Google puede rastrear una página sin llegar a indexarla.
El rastreo está relacionado principalmente con descubrir y acceder a recursos. La indexación se produce posteriormente y está relacionada con procesar, interpretar, consolidar y decidir cómo tratar ese contenido dentro del índice.
Por tanto, cuando analizamos indexación vs rastreo en Google, no debemos utilizar ambos conceptos como sinónimos. Una URL rastreable no es automáticamente una URL indexada.
Una página puede ser rastreada pero no indexada
Este escenario es relativamente habitual. Googlebot accede correctamente a la URL, pero posteriormente los sistemas de Google pueden decidir no incorporarla al índice o seleccionar otra URL como representativa.
Aquí debemos investigar la calidad y singularidad del contenido, canonicalización, duplicidades y otras señales relacionadas con la página.
Una página puede no ser rastreada
También podemos encontrarnos con URLs que Google conoce pero a las que no ha accedido recientemente, o páginas cuyo rastreo está restringido.
El diagnóstico será diferente porque nuestro objetivo inicial consistirá en comprobar descubrimiento, accesibilidad, arquitectura y posibles bloqueos.
Rastreo, indexación y posicionamiento no son lo mismo
Existe un tercer concepto que debemos separar de los anteriores: posicionamiento.
Una página puede estar correctamente rastreada e indexada y ocupar posiciones muy bajas para las consultas que nos interesan. En ese escenario no estamos necesariamente ante un problema de indexación.
Para aparecer competitivamente en las búsquedas necesitamos trabajar relevancia, contenido, autoridad, intención de búsqueda, experiencia y otros elementos SEO.
Entender esta secuencia evita diagnósticos equivocados. Cuando una URL no recibe tráfico, comprobamos si está indexada antes de asumir que simplemente necesita más optimización para palabras clave.
Cómo funciona el proceso desde que publicamos una página
Para comprender mejor indexación vs rastreo en Google, podemos observar el recorrido que sigue una URL desde que aparece en nuestra web.
Google necesita descubrir su existencia mediante enlaces, sitemaps u otras fuentes. Posteriormente puede programar su rastreo, acceder al recurso y procesar el contenido.
Si considera que la página puede formar parte de su índice, podrá incorporarla. A partir de ahí, los sistemas de búsqueda pueden valorar cuándo resulta relevante mostrarla ante determinadas consultas.
Este proceso no tiene por qué producirse instantáneamente. Google advierte en su documentación que puede necesitar varios días después de publicar una página para descubrirla y rastrearla.
El papel de Googlebot en el rastreo
Googlebot solicita recursos de las webs siguiendo las reglas y condiciones aplicables al rastreo.
Para que pueda analizar adecuadamente una página necesitamos asegurarnos de que el servidor responde correctamente y de que los recursos necesarios no están restringidos de manera innecesaria.
Códigos de respuesta HTTP
Una página que queremos posicionar debería responder de forma coherente con su estado real. Los errores del servidor, redirecciones mal configuradas y respuestas incorrectas pueden dificultar el procesamiento.
Nosotros revisamos estos códigos durante las auditorías porque permiten detectar rápidamente secciones inaccesibles, cadenas de redirecciones y páginas que ya no existen.
Renderizado y recursos
Las webs modernas pueden depender considerablemente de JavaScript para generar contenido. Google dispone de sistemas de renderizado, pero una configuración técnica deficiente puede impedir que determinados elementos importantes se procesen como esperamos.
Por eso comprobamos lo que realmente puede encontrar el buscador y no únicamente lo que vemos nosotros al abrir una página en el navegador.
Cómo influye robots.txt en el rastreo
robots.txt es un archivo que permite establecer reglas sobre las partes de un sitio a las que determinados rastreadores pueden acceder.
Este punto resulta especialmente importante al estudiar indexación vs rastreo en Google, porque bloquear el rastreo no equivale exactamente a solicitar la eliminación de una URL del índice.
Google explica que una regla Disallow impide que sus rastreadores accedan al contenido de una ruta, pero la URL todavía podría llegar a aparecer en los resultados sin fragmento si Google conoce su existencia por otras vías.
Robots.txt no es una herramienta para desindexar
Si nuestro objetivo consiste en impedir que determinada página aparezca en Google, utilizar exclusivamente robots.txt puede ser una decisión incorrecta.
Si además bloqueamos el acceso, Googlebot puede no llegar a consultar las instrucciones que existen dentro de la propia página.
Esta diferencia técnica demuestra por qué es tan importante comprender qué queremos controlar: acceso del rastreador o presencia en el índice.
Cómo funciona la directiva noindex
noindex está relacionada específicamente con la indexación. Cuando Google puede rastrear una página y procesa correctamente esta directiva, le estamos indicando que no queremos que esa URL permanezca en sus resultados.
Por eso no debemos bloquear simultáneamente mediante robots.txt una página si necesitamos que Google acceda a ella para procesar un noindex.
La documentación de Google sobre diferentes funciones de búsqueda recuerda que una página debe ser accesible y no estar bloqueada por robots.txt, noindex o requisitos de acceso cuando queremos que pueda participar en determinadas funciones de resultados.
La importancia del sitemap XML
El sitemap facilita a los buscadores una relación estructurada de URLs que consideramos relevantes.
En nuestra estrategia SEO procuramos incluir páginas indexables, canónicas y útiles, evitando llenar el sitemap con redirecciones, errores o contenidos que expresamente queremos excluir.
Un sitemap no obliga a Google a indexar
Este matiz es esencial dentro de indexación vs rastreo en Google. Enviar una URL mediante un sitemap facilita su descubrimiento, pero no constituye una orden de indexación.
Google continúa evaluando esa página antes de decidir cómo tratarla dentro de sus sistemas.
Por ello, reenviar repetidamente un sitemap no solucionará necesariamente un problema relacionado con contenido duplicado, baja calidad o canonicalización.
Canonicalización e indexación
Cuando varias URLs contienen información duplicada o muy similar, Google puede agruparlas y seleccionar una versión representativa.
Google denomina canonicalización al proceso de elegir esa URL principal. Entre las señales que puede utilizar se encuentran redirecciones, inclusión en sitemaps y anotaciones rel=»canonical», aunque Google puede seleccionar una canónica diferente de la que nosotros indicamos.
Por qué una URL rastreada puede no aparecer
Imagina dos direcciones que muestran prácticamente el mismo contenido. Google puede visitar ambas y posteriormente decidir utilizar solamente una como versión representativa.
Desde el punto de vista del rastreo las dos han sido accesibles, pero su tratamiento durante la indexación es diferente.
Este ejemplo representa perfectamente la diferencia entre indexación vs rastreo en Google.
Qué es el presupuesto de rastreo
El presupuesto de rastreo representa los recursos que Google puede dedicar a explorar un sitio. Según su documentación, está determinado principalmente por el límite de capacidad de rastreo y la demanda de rastreo.
Para una web pequeña con unas pocas decenas o cientos de URLs, obsesionarse con este concepto suele aportar menos valor que resolver problemas básicos de arquitectura, contenido o indexabilidad.
En proyectos con una enorme cantidad de URLs, como grandes ecommerce, medios o portales, la eficiencia de rastreo puede adquirir mucha más importancia.
URLs que consumen rastreo innecesariamente
Filtros, parámetros, calendarios, búsquedas internas y combinaciones prácticamente infinitas pueden generar grandes espacios de URLs.
Cuando el buscador dedica recursos a recorrer estas direcciones, puede tardar más en volver a visitar páginas que realmente nos interesan.
La solución debe estudiarse según la tecnología y arquitectura de cada sitio, evitando aplicar bloqueos generales sin analizar previamente sus consecuencias.
Problemas frecuentes de rastreo
Cuando detectamos un problema de rastreo buscamos qué está dificultando que Googlebot acceda a las páginas importantes.
Bloqueos accidentales en robots.txt
Un Disallow incorrectamente configurado puede impedir que Googlebot acceda a directorios completos.
Este error aparece con frecuencia después de migraciones o cuando configuraciones utilizadas en un entorno de pruebas terminan publicándose en producción.
Arquitectura demasiado profunda
Una página importante que necesita demasiados saltos desde la portada puede resultar menos accesible dentro de la estructura.
El enlazado interno debe permitir que buscadores y usuarios lleguen de manera lógica a los contenidos relevantes.
Páginas huérfanas
Una URL sin enlaces internos puede resultar más difícil de descubrir y además queda desconectada de la jerarquía temática del sitio.
Aunque pueda aparecer en un sitemap, nosotros preferimos que las páginas estratégicas estén integradas naturalmente dentro de la arquitectura.
Errores del servidor
Problemas recurrentes de disponibilidad pueden limitar la capacidad de Google para acceder al sitio.
La documentación de Google indica que la capacidad del servidor forma parte de los factores que condicionan cuánto puede rastrear Googlebot sin provocar problemas al sitio.
Problemas frecuentes de indexación
Los problemas de indexación requieren un diagnóstico diferente. Aquí Google puede conocer y haber rastreado la URL, pero esta no termina consolidándose como esperamos dentro del índice.
Contenido duplicado o muy similar
Cuando existen varias URLs equivalentes, Google puede elegir una versión canónica y tratar las demás como duplicadas.
Debemos analizar si esas páginas realmente necesitan existir de forma independiente o si la arquitectura está creando duplicaciones innecesarias.
Canonical incorrecta
Una página puede declarar como canonical otra URL debido a un error de plantilla.
En webs grandes, una configuración incorrecta puede afectar automáticamente a miles de páginas, por lo que recomendamos revisar patrones y no solamente URLs aisladas.
Directivas noindex involuntarias
Un noindex puede permanecer después de un rediseño, una migración o una modificación de plantillas.
Si la URL debería posicionarse, esta directiva contradice directamente nuestro objetivo.
Contenido con escaso valor diferencial
Que una URL sea técnicamente indexable no significa que Google tenga que mantenerla en el índice.
Si generamos cientos de páginas prácticamente idénticas y sin utilidad diferencial, solucionar exclusivamente los elementos técnicos puede no resolver el problema.
Cómo detectar problemas con Google Search Console
Search Console es una de las herramientas principales que utilizamos para diagnosticar indexación vs rastreo en Google.
La herramienta de inspección de URLs permite analizar cómo Google trata una dirección concreta y revisar información relacionada con rastreo, indexación y canonicalización.
Inspeccionar una URL concreta
Cuando una página importante no aparece como esperamos, la inspeccionamos individualmente.
Queremos saber si Google conoce la URL, cuándo la rastreó, qué estado presenta y si existe alguna diferencia entre la canonical declarada y la seleccionada por Google.
Analizar patrones, no solamente páginas
Una única URL problemática puede ser una incidencia aislada. Cientos de URLs con el mismo estado suelen indicar un problema estructural.
Nosotros agrupamos las incidencias por tipología, plantilla y sección para encontrar la causa común antes de modificar individualmente cada página.
Qué hacer si Google rastrea una página pero no la indexa
Este escenario requiere analizar por qué la URL no está siendo incorporada como esperamos.
No recomendamos solicitar indexación repetidamente sin modificar nada. Si existe un problema de fondo, insistir sobre la misma URL no elimina su causa.
Revisamos calidad y originalidad del contenido, intención de búsqueda, canonical, duplicidades, enlaces internos, códigos HTTP y coherencia con el resto de la arquitectura.
También analizamos si realmente esa página merece existir como URL independiente. En ocasiones, consolidar varios contenidos débiles en uno más completo constituye una solución mejor que intentar forzar la indexación de todos.
Qué hacer si Google no rastrea una página importante
Aquí nuestra prioridad cambia. Necesitamos facilitar su descubrimiento y acceso.
Comprobamos robots.txt, enlaces internos, sitemap, respuestas del servidor y profundidad dentro de la arquitectura.
También verificamos que la URL no dependa exclusivamente de mecanismos de navegación difíciles de descubrir para un rastreador.
Una vez solucionado el problema técnico podemos utilizar las herramientas disponibles en Search Console para comprobar cómo Google accede a la página.
Indexación vs rastreo en Google en tiendas online
Los ecommerce representan uno de los escenarios donde esta distinción resulta especialmente relevante.
Filtros, ordenaciones, parámetros, variantes y paginaciones pueden multiplicar rápidamente el número de URLs disponibles para los rastreadores.
Si permitimos que todas las combinaciones generen direcciones accesibles sin una estrategia, podemos crear un espacio de rastreo enorme y una gran cantidad de páginas duplicadas o poco diferenciadas.
En estos proyectos, el análisis de indexación vs rastreo en Google debe integrarse con la arquitectura de categorías, navegación facetada, canonicalización, enlazado interno y estrategia de contenidos.
Indexación vs rastreo en Google después de una migración
Una migración modifica las señales que Google conoce y obliga a sus sistemas a volver a procesar parte del sitio.
Google explica que durante un traslado necesita visitar las URLs antiguas y nuevas y que el procesamiento se realiza URL por URL. También señala que pueden producirse fluctuaciones temporales mientras vuelve a rastrear e indexar el sitio.
Por ello, después de una migración monitorizamos ambas dimensiones. No basta con comprobar que las redirecciones funcionan; necesitamos observar cómo Google descubre, rastrea e incorpora las nuevas URLs.
Cómo mejorar el rastreo de una web
Mejorar el rastreo no significa intentar que Google visite absolutamente todas las URLs posibles. Nuestro objetivo es facilitar el acceso a las páginas que realmente aportan valor.
Una arquitectura lógica, un enlazado interno coherente y sitemaps limpios ayudan a señalar qué contenidos son importantes.
También debemos eliminar o controlar espacios de URLs innecesarios cuando generan una cantidad desproporcionada de recursos sin valor para las búsquedas.
En proyectos grandes analizamos además logs del servidor para conocer qué está solicitando realmente Googlebot y con qué frecuencia.
Cómo favorecer una indexación más limpia
Para conseguir una indexación eficiente necesitamos decidir qué páginas merecen formar parte del índice.
No todas las URLs técnicas de una web deberían posicionarse. Áreas privadas, resultados internos, combinaciones irrelevantes o páginas sin contenido diferencial pueden necesitar otro tratamiento.
La coherencia entre sitemap, canonical, enlazado interno y directivas de indexación facilita que nuestras señales sean interpretables.
Esta visión permite trabajar indexación vs rastreo en Google como partes relacionadas de una misma estrategia sin confundir la función de cada una.
Por qué no debes obsesionarte con tener todas las URLs indexadas
Un porcentaje de indexación elevado no constituye por sí mismo un objetivo empresarial.
Si una web genera miles de URLs mediante parámetros pero solamente unas cientos responden a búsquedas relevantes, intentar indexarlas todas puede ser contraproducente.
Nosotros preferimos analizar si las páginas estratégicas están correctamente disponibles y si la arquitectura evita generar grandes cantidades de contenido redundante.
La pregunta adecuada no es solamente cuántas páginas tenemos indexadas, sino cuáles necesitamos posicionar y qué valor ofrecen a quien realiza la búsqueda.
Cómo trabajamos el rastreo y la indexación en una auditoría SEO
En nuestra empresa comenzamos rastreando la web para conocer su arquitectura técnica, códigos de respuesta, canonical, directivas, enlaces internos y profundidad.
Contrastamos posteriormente estos datos con la información que Google proporciona a través de Search Console.
Esta comparación permite descubrir diferencias entre cómo creemos que funciona el sitio y cómo Google está tratando realmente sus URLs.
Cuando encontramos incidencias relacionadas con indexación vs rastreo en Google, priorizamos aquellas que afectan a páginas capaces de generar tráfico, conversiones o autoridad. Así evitamos dedicar recursos a corregir URLs que no aportan ningún valor estratégico.
Conclusión: entender rastreo e indexación para diagnosticar correctamente tu SEO
La diferencia entre indexación vs rastreo en Google es sencilla en concepto, pero fundamental en cualquier auditoría SEO. El rastreo permite que Googlebot descubra y acceda a las páginas; la indexación implica que Google procese esas páginas y pueda incorporarlas a su índice. Una URL rastreada no tiene por qué terminar indexada y una URL indexada tampoco tiene garantizado un buen posicionamiento. Google confirma expresamente que no todas las páginas que rastrea terminan formando parte del índice, por lo que cada problema requiere un diagnóstico específico.
En nuestra agencia SEO analizamos rastreo, indexación, arquitectura y posicionamiento como partes conectadas de una misma estrategia SEO. Si tu web tiene páginas que Google no descubre, URLs rastreadas que no consigue indexar o contenidos importantes que han desaparecido de los resultados, podemos identificar la causa técnica y definir las acciones necesarias para recuperar una estructura más eficiente y preparada para posicionar.
Comentarios recientes